14. 故障树不确定性#
除了Anaconda中已有的库外,本讲座还需要以下库:
!pip install quantecon tabulate
14.1. 概述#
本讲将运用基本工具来近似计算由多个关键部件组成的系统的年度故障率的概率分布。
我们将使用对数正态分布来近似关键部件的概率分布。
为了近似描述系统总故障率(表示为 \(n\) 个对数正态随机变量之和)的概率分布,我们计算这些分布的卷积。
我们将使用以下概念和工具:
对数正态分布
描述独立随机变量之和的概率分布的卷积定理
用于近似多组件系统故障率的故障树分析
用于描述不确定概率的层次概率模型
傅里叶变换和傅里叶逆变换作为计算序列卷积的高效方法
El-Shanawany et al. [2018] 和 Greenfield and Sargent [1993] 应用了这些方法来近似核设施安全系统的故障概率。
这些技术响应了 Apostolakis [1990] 提出的关于量化安全系统可靠性不确定性的建议。
本讲座将使用以下导入和设置:
import numpy as np
import matplotlib.pyplot as plt
import matplotlib as mpl
FONTPATH = "fonts/SourceHanSerifSC-SemiBold.otf"
mpl.font_manager.fontManager.addfont(FONTPATH)
plt.rcParams['font.family'] = ['Source Han Serif SC']

from scipy.signal import fftconvolve
from tabulate import tabulate
import quantecon as qe
14.2. 对数正态分布#
如果随机变量 \(x\) 服从均值为 \(\mu\)、方差为 \(\sigma^2\) 的正态分布,那么 \(y = \exp(x)\) 服从参数为 \(\mu, \sigma^2\) 的对数正态分布。
备注
我们将 \(\mu\) 和 \(\sigma^2\) 称为参数而不是均值和方差,因为:
\(\mu\) 和 \(\sigma^2\) 是 \(x = \log(y)\) 的均值和方差
它们不是 \(y\) 的均值和方差
\(y\) 的均值是 \(\exp(\mu + \frac{1}{2}\sigma^2)\),方差是 \((e^{\sigma^2} - 1) e^{2\mu + \sigma^2}\)
对数正态随机变量 \(y\) 始终是非负的。
\(y\) 的概率密度函数是
对数正态随机变量的重要特性是:
14.2.1. 稳定性性质#
回顾独立正态分布随机变量具有以下稳定性性质:
如果 \(x_1 \sim N(\mu_1, \sigma_1^2)\) 和 \(x_2 \sim N(\mu_2, \sigma_2^2)\) 是独立的,那么 \(x_1 + x_2 \sim N(\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2)\)。
独立的对数正态分布具有不同的稳定性性质:独立对数正态随机变量的乘积也是对数正态分布。
具体来说,如果 \(y_1\) 是参数为 \((\mu_1, \sigma_1^2)\) 的对数正态分布,且 \(y_2\) 是参数为 \((\mu_2, \sigma_2^2)\) 的对数正态分布,那么 \(y_1 y_2\) 是参数为 \((\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2)\) 的对数正态分布。
警告
虽然两个对数正态分布的乘积是对数正态分布,但两个对数正态分布的和却不是对数正态分布。
这个观察结果引出了本讲座的核心挑战:近似独立对数正态随机变量之和的概率分布。
14.3. 卷积定理#
设 \(x\) 和 \(y\) 是概率密度分别为 \(f(x)\) 和 \(g(y)\) 的独立随机变量,其中 \(x, y \in \mathbb{R}\)。
设 \(z = x + y\)。
那么 \(z\) 的概率密度为
其中 \((f*g)\) 表示 \(f\) 和 \(g\) 的卷积。
对于非负随机变量,这可以特化为
14.3.1. 离散卷积#
我们将使用卷积公式的离散化版本。
我们将 \(f\) 和 \(g\) 都替换为离散化的对应形式,并归一化使其和为 1。
离散卷积公式为
这计算了两个离散随机变量之和的概率质量函数。
14.3.2. 示例:离散分布#
考虑两个概率质量函数:
和
\(Z = X + Y\) 的分布由卷积 \(h = f * g\) 给出。
# 定义概率质量函数
f = [0.75, 0.25]
g = [0.0, 0.6, 0.0, 0.4]

# 使用两种方法计算卷积
h = np.convolve(f, g)
hf = fftconvolve(f, g)

print(f"f = {f}, sum = {np.sum(f):.3f}")
print(f"g = {g}, sum = {np.sum(g):.3f}")
print(f"h = {h}, sum = {np.sum(h):.3f}")
print(f"hf = {hf}, sum = {np.sum(hf):.3f}")
f = [0.75, 0.25], sum = 1.000
g = [0.0, 0.6, 0.0, 0.4], sum = 1.000
h = [0.   0.45 0.15 0.3  0.1 ], sum = 1.000
hf = [0.   0.45 0.15 0.3  0.1 ], sum = 1.000
numpy.convolve 和 scipy.signal.fftconvolve 都得到相同的结果,但对于长序列,fftconvolve 要快得多。
为了提高效率,本讲座将始终使用 fftconvolve。
14.4. 近似连续分布#
现在我们验证离散化分布能否准确近似来自底层连续分布的样本。
我们从三个独立的对数正态随机变量中生成25,000个样本,并计算它们的两两之和与三者之和。
然后我们将样本的直方图与离散化分布的直方图进行比较。
# 设置对数正态分布的参数
μ, σ = 5.0, 1.0
n_samples = 25000

# 生成样本
rng = np.random.default_rng(1234)
s1 = rng.lognormal(μ, σ, n_samples)
s2 = rng.lognormal(μ, σ, n_samples)
s3 = rng.lognormal(μ, σ, n_samples)

# 计算和
ssum2 = s1 + s2
ssum3 = s1 + s2 + s3

# 绘制 s1 的直方图
fig, ax = plt.subplots()
ax.hist(s1, 1000, density=True, alpha=0.6)
ax.set_xlabel('数值')
ax.set_ylabel('密度')
plt.show()
findfont: Failed to find font weight normal, now using 600.
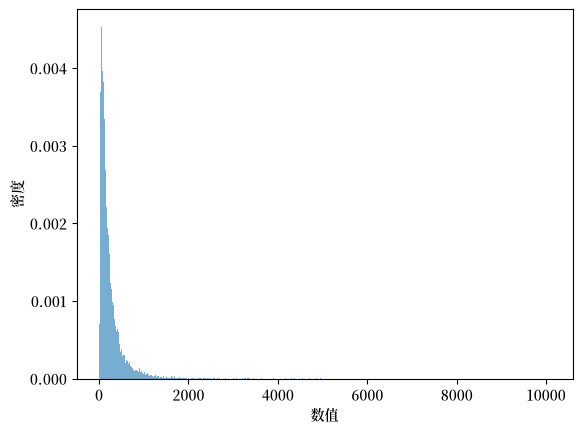
图 14.1 单个对数正态分布的样本直方图#
# 绘制两个对数正态分布之和的直方图
fig, ax = plt.subplots()
ax.hist(ssum2, 1000, density=True, alpha=0.6)
ax.set_xlabel('数值')
ax.set_ylabel('密度')
plt.show()
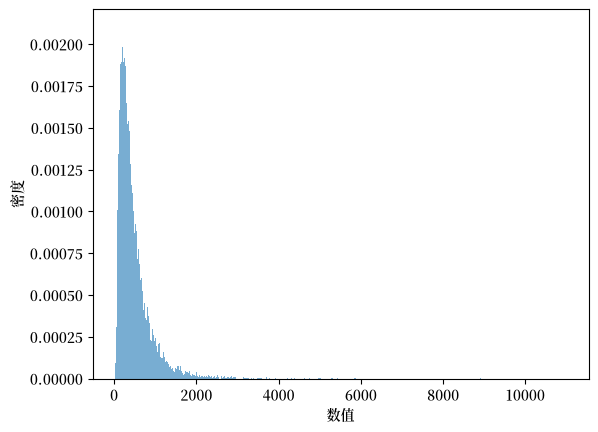
图 14.2 两个对数正态分布之和的直方图#
# 绘制三个对数正态分布之和的直方图
fig, ax = plt.subplots()
ax.hist(ssum3, 1000, density=True, alpha=0.6)
ax.set_xlabel('数值')
ax.set_ylabel('密度')
plt.show()
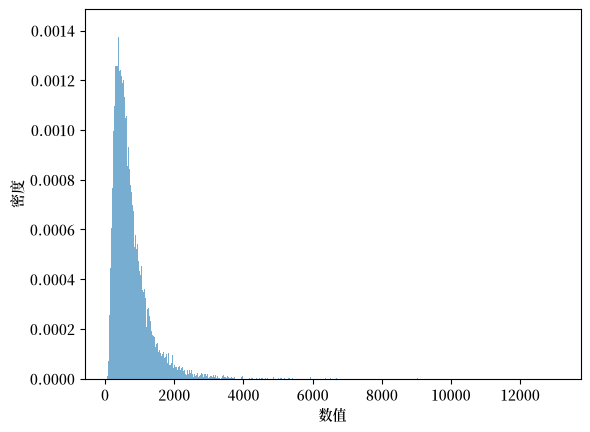
图 14.3 三个对数正态分布之和的直方图#
让我们验证样本均值是否与理论均值相匹配:
samp_mean = np.mean(s2)
theoretical_mean = np.exp(μ + σ**2 / 2)

print(f"理论均值: {theoretical_mean:.3f}")
print(f"样本均值: {samp_mean:.3f}")
理论均值: 244.692
样本均值: 243.197
14.5. 离散化对数正态分布#
我们定义辅助函数来创建对数正态概率密度函数的离散化版本。
我们手动写出该密度函数,以便与公式 (14.1) 对照;scipy.stats.lognorm(s=σ, scale=np.exp(μ)).pdf(x) 计算的是同样的内容。
def lognormal_pdf(x, μ, σ):
    """
    计算对数正态概率密度函数。
    """
    p = 1 / (σ * x * np.sqrt(2 * np.pi)) \
            * np.exp(-0.5 * ((np.log(x) - μ) / σ)**2)
    return p


def discretize_lognormal(μ, σ, I, m):
    """
    在网格 0, m, 2m, ..., 直到 I 上离散化对数正态分布。

    参数
    ----------
    μ, σ : 对数正态分布的参数
    I    : 网格的上限,用于截断右尾
    m    : 网格点之间的间距,决定分辨率

    返回
    -------
    p_array      : 在网格上计算得到的密度
    p_array_norm : 隐含的概率质量函数,其和为1
    x            : 网格本身,共有 I / m 个点
    """
    x = np.arange(1e-7, I, m)
    p_array = lognormal_pdf(x, μ, σ)
    p_array_norm = p_array / np.sum(p_array)
    return p_array, p_array_norm, x
有两个独立的选择决定了这一近似的质量,最好将它们分清楚。
\(I\) 决定网格的终止点,因此它控制我们舍弃了多少右尾部分
\(m\) 决定网格点之间的间距,因此它控制分辨率
网格共有 \(I/m\) 个点,因此在 \(m\) 固定时增大 \(I\) 会扩大覆盖范围,而在 \(I\) 固定时减小 \(m\) 会提高精度。
一旦 \(I\) 足够大,使得几乎没有概率质量落在其之外,再进一步增大它就不会改变结果,此时只有 \(m\) 起作用。
练习 14.1 要求你验证这一点。
备注
scipy.signal.fftconvolve 会在内部自动将输入填充到合适的长度,因此无需将 \(I/m\) 选为 2 的幂。
# 设置网格参数
p = 15
I = 2**p  # 网格的终止点:截断右尾
m = 0.1   # 网格点之间的间距:决定分辨率
让我们直观地看一下离散化分布对连续对数正态分布的近似效果:
# 计算离散化的概率密度函数
pdf, pdf_norm, x = discretize_lognormal(μ, σ, I, m)

# 绘制离散化的概率密度函数与直方图的对比
fig, ax = plt.subplots(figsize=(10, 6))
ax.plot(x, pdf, 'r-', lw=2, label='离散化概率密度函数')
ax.hist(s1, 1000, density=True, alpha=0.6, label='样本直方图')
ax.set_xlim(0, 2500)
ax.set_xlabel('数值')
ax.set_ylabel('密度')
ax.legend()
plt.show()
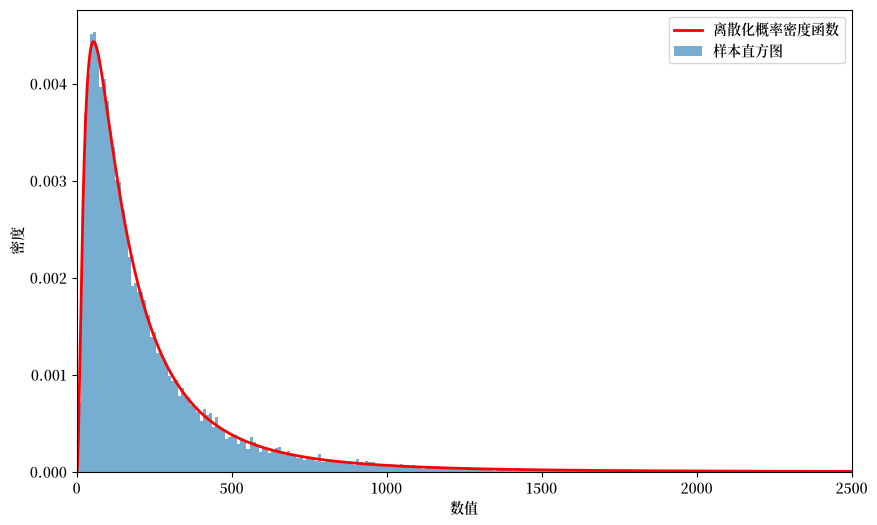
图 14.4 离散化密度与样本的对比#
现在让我们验证离散化分布是否具有正确的均值:
# 从离散化的概率密度函数计算均值
mean_discrete = np.sum(x * pdf_norm)
mean_theory = np.exp(μ + 0.5 * σ**2)

print(f"理论均值: {mean_theory:.3f}")
print(f"离散化均值: {mean_discrete:.3f}")
理论均值: 244.692
离散化均值: 244.691
14.6. 概率质量函数的卷积#
现在我们使用卷积定理来计算上面参数化的两个对数正态随机变量之和的概率分布。
我们还将计算上面构造的三个对数正态分布之和的概率分布。
对于长序列,scipy.signal.fftconvolve 比 numpy.convolve 快得多,因为它使用了快速傅里叶变换。
让我们先定义傅里叶变换和傅里叶逆变换
14.6.1. 快速傅里叶变换#
序列 \(\{x_t\}_{t=0}^{T-1}\) 的傅里叶变换是
其中 \(\omega_j = \frac{2\pi j}{T}\),\(j = 0, 1, \ldots, T-1\)。
序列 \(\{x(\omega_j)\}_{j=0}^{T-1}\) 的傅里叶逆变换是
序列 \(\{x_t\}_{t=0}^{T-1}\) 和 \(\{x(\omega_j)\}_{j=0}^{T-1}\) 包含相同的信息。
方程对 (14.6) 和 (14.7) 说明了如何从一个序列恢复其傅里叶对应序列。
程序 scipy.signal.fftconvolve 利用了两个序列 \(\{f_k\}\)、\(\{g_k\}\) 的卷积可以通过以下方式计算的定理:
计算序列 \(\{f_k\}\) 和 \(\{g_k\}\) 的傅里叶变换 \(F(\omega)\)、\(G(\omega)\)
形成乘积 \(H (\omega) = F(\omega) G (\omega)\)
卷积 \(f * g\) 是 \(H(\omega)\) 的傅里叶逆变换
快速傅里叶变换和相关的快速傅里叶逆变换能够非常快速地执行这些计算。
这就是 fftconvolve 使用的算法。
让我们做一个预热计算,比较 numpy.convolve 和 scipy.signal.fftconvolve 所需的时间
我们的三个分量是同分布的,因此单次离散化就足以适用于所有分量。
# 离散化对数正态分布;三个分量是独立同分布的
_, pmf1, x = discretize_lognormal(μ, σ, I, m)
pmf2 = pmf3 = pmf1

# 直接卷积的成本为 O(N²),因此我们只对一个较短的前缀部分计时
short = pmf1[:20_000]

with qe.Timer() as timer_numpy:
    np.convolve(short, short)
time_numpy = timer_numpy.elapsed

with qe.Timer() as timer_fft:
    fftconvolve(short, short)
time_fft = timer_fft.elapsed

print(f"在 {len(short):,} 个点上:")
print(f"  np.convolve: {time_numpy:.4f} 秒")
print(f"  fftconvolve: {time_fft:.4f} 秒")
print(f"  加速倍数:     {time_numpy / time_fft:.0f}x")
0.0424 seconds elapsed
0.0016 seconds elapsed
在 20,000 个点上:
  np.convolve: 0.0424 秒
  fftconvolve: 0.0016 秒
  加速倍数:     26x
随着序列长度的增加,这一差距会迅速扩大,因为直接卷积的计算成本为 \(O(N^2)\),而 FFT 方法的计算成本为 \(O(N \log N)\)。
在下面使用的完整网格上,直接方法的速度会更慢。
# 使用快速方法完成完整计算
conv_fft = fftconvolve(fftconvolve(pmf1, pmf2), pmf3)
print(f"每个分量的网格点数: {len(pmf1):,}")
每个分量的网格点数: 327,680
现在让我们将计算得到的两个对数正态随机变量之和的概率质量函数近似值与我们上面形成的样本直方图进行对比绘制
# 计算两个分布的卷积以进行比较
conv2 = fftconvolve(pmf1, pmf2)

fig, ax = plt.subplots(figsize=(10, 6))
ax.plot(x, conv2[:len(x)] / m, 'r-', lw=2, label='卷积 (FFT)')
ax.hist(ssum2, 1000, density=True, alpha=0.6, label='样本直方图')
ax.set_xlim(0, 5000)
ax.set_xlabel('数值')
ax.set_ylabel('密度')
ax.legend()
plt.show()
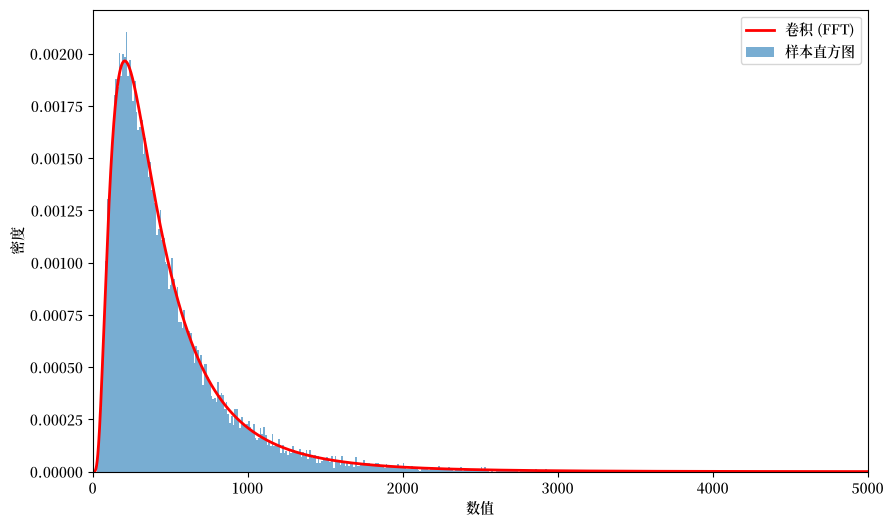
图 14.5 卷积与样本的对比,两个分量#
现在我们展示三个对数正态随机变量之和的图:
fig, ax = plt.subplots(figsize=(10, 6))
ax.plot(x, conv_fft[:len(x)] / m, 'r-', lw=2, label='卷积 (FFT)')
ax.hist(ssum3, 1000, density=True, alpha=0.6, label='样本直方图')
ax.set_xlim(0, 5000)
ax.set_xlabel('数值')
ax.set_ylabel('密度')
ax.legend()
plt.show()
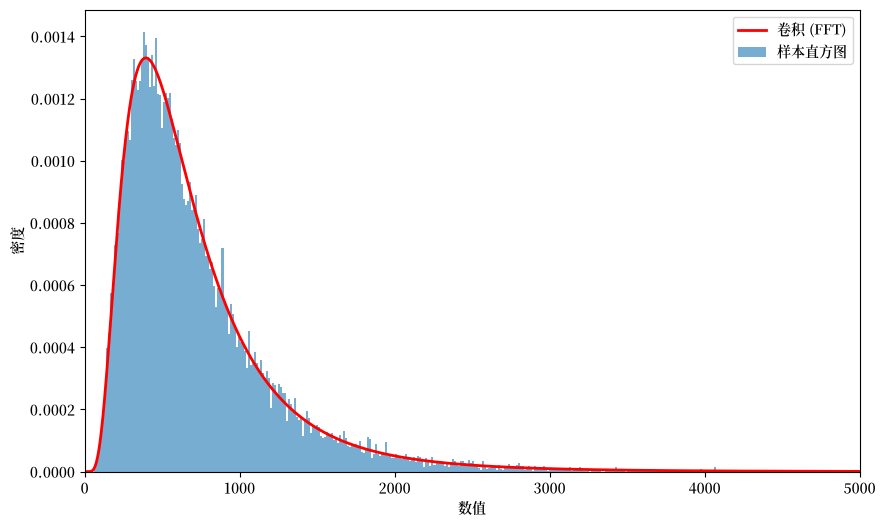
图 14.6 卷积与样本的对比,三个分量#
让我们验证均值是否正确
# 两个分布之和的均值
mean_conv2 = np.sum(x * conv2[:len(x)])
mean_theory2 = 2 * np.exp(μ + 0.5 * σ**2)

print(f"两个分布之和:")
print(f"  理论均值: {mean_theory2:.3f}")
print(f"  计算均值: {mean_conv2:.3f}")
两个分布之和:
  理论均值: 489.384
  计算均值: 489.381
# 三个分布之和的均值
mean_conv3 = np.sum(x * conv_fft[:len(x)])
mean_theory3 = 3 * np.exp(μ + 0.5 * σ**2)

print(f"三个分布之和:")
print(f"  理论均值: {mean_theory3:.3f}")
print(f"  计算均值: {mean_conv3:.3f}")
三个分布之和:
  理论均值: 734.076
  计算均值: 734.071
14.7. 故障树分析#
我们即将应用卷积定理来计算故障树分析中顶事件的概率。
在应用卷积定理之前,我们首先描述将组成事件与我们要量化其故障率的顶事件连接起来的模型。
正如 El-Shanawany et al. [2018] 所描述的,故障树分析是一种广泛使用的评估系统可靠性的技术。
为了构建统计模型,我们反复使用所谓的稀有事件近似。
14.7.1. 稀有事件近似#
我们想要计算事件 \(A \cup B\) 的概率。
对于事件 \(A\) 和 \(B\),并集的概率为
其中 \(A \cup B\) 是事件 \(A\) 或 \(B\) 发生的情况,\(A \cap B\) 是事件 \(A\) 和 \(B\) 都发生的情况。
如果 \(A\) 和 \(B\) 是独立的,那么 \(P(A \cap B) = P(A) P(B)\)。
当 \(P(A)\) 和 \(P(B)\) 都很小时,\(P(A) P(B)\) 就更小。
稀有事件近似为
这种近似方法在系统故障分析中被广泛使用。
14.7.2. 系统故障概率#
考虑一个具有 \(n\) 个关键组件的系统,当任何一个组件发生故障时,系统就会发生故障。
我们假设:
每个组件 \(A_i\) 的故障概率 \(P(A_i)\) 都很小
组件故障在统计上是独立的
我们反复应用稀有事件近似,得到系统故障概率问题的以下公式:
或
其中 \(P(F)\) 是系统故障概率。
每个事件的概率以每年故障率的形式记录。
备注
严格来说,每年的故障率与一年内的故障概率是不同的概念。
对于稀有事件,两者几乎相等,因为当 \(\lambda\) 很小时,\(1 - e^{-\lambda} \approx \lambda\)。
正是同样让我们能够跨组件相加概率的近似方法,也让我们能够在故障率与概率之间相互转换,因此我们遵循可靠性文献的惯例,在此交替使用这两个术语。
14.8. 未知的故障率#
现在我们来讨论真正感兴趣的问题,遵循 El-Shanawany et al. [2018] 和 Greenfield and Sargent [1993] 的方法,秉承 Apostolakis [1990] 的精神。
组件故障率 \(P(A_i)\) 并非精确已知,需要进行估计。
我们通过指定概率的概率来解决这个问题,这体现了不了解作为故障树分析输入的构成概率的一种概念。
因此,我们假设系统分析师对系统组件的故障率 \(P(A_i), i =1, \ldots, n\) 存在不确定性。
分析师通过将系统的故障概率 \(P(F)\) 和每个组件概率 \(P(A_i)\) 视为随机变量来应对这种情况。
\(P(A_i)\) 概率分布的离散程度表征了分析师对故障概率 \(P(A_i)\) 的不确定性
\(P(F)\) 的隐含概率分布的离散程度表征了他对系统故障概率的不确定性
这就是所谓的层次化模型,其中分析师对概率 \(P(A_i)\) 本身也有概率估计。
备注
该模型中出现了两种截然不同的随机性,值得加以区分。
偶然性(Aleatory)不确定性是指某个组件在给定年份内是否发生故障的随机性,它由故障率 \(P(A_i)\) 来描述。
认知性(Epistemic)不确定性是指分析师对该故障率取值的无知,它由分析师赋予 \(P(A_i)\) 的对数正态分布来描述。
我们下面计算的分布是一个认知性对象:它描述的是分析师对某个故障率的了解程度,而不是系统实际发生故障的频率。
将两者区分开来是 Apostolakis [1990] 的核心建议。
分析师通过以下假设来形式化他的不确定性:
故障概率 \(P(A_i)\) 本身是一个对数正态随机变量,其参数为 \((\mu_i, \sigma_i)\)。
对于所有 \(i \neq j\) 的配对,故障率 \(P(A_i)\) 和 \(P(A_j)\) 在统计上是相互独立的。
分析师通过阅读工程论文中的可靠性研究来校准故障事件 \(i = 1, \ldots, n\) 的参数 \((\mu_i, \sigma_i)\),这些研究考察了与所研究系统中使用的组件尽可能相似的组件的历史故障率。
分析师假设,这些关于年度故障率或故障时间的观测分散性的信息,可以帮助他预测零件在其系统中的性能表现。
分析师假设随机变量 \(P(A_i)\) 在统计上是相互独立的。
警告
独立性是一个很强的假设,也是可靠性分析师最为担心的一点。
设计缺陷、共用的电源、共同的维护团队,或单一的环境冲击,都可能同时使多个组件趋向故障。
这类共因故障会使 \(P(F)\) 分布的尾部远比独立性假设下计算出的结果更为肥厚,而这恰恰是安全监管者最为关心的区域。
练习 14.5 对这种差异究竟有多大进行了量化。
分析师想要近似系统的故障概率 \(P(F)\) 的概率质量函数和累积分布函数。
我们说概率质量函数是因为我们对每个随机变量进行了离散化,正如前文描述的那样。
分析师通过重复应用卷积定理来计算顶事件 \(F\)(即系统故障)的概率质量函数,以计算独立对数正态随机变量之和的概率分布,如方程 (14.8) 所述。
14.9. 应用:废物提升机失效率#
现在我们分析一个具有 \(n = 14\) 个组件的真实案例。
该应用估计了核废料设施中一个关键提升机的年度故障率。
监管机构要求系统的设计能够使顶事件的故障率以高概率保持在较小值。
14.9.1. 模型设定#
这个例子是 Greenfield and Sargent [1993] 第27页表10中描述的设计方案B-2(案例I)。
该表描述了十四个对数正态随机变量的参数 \(\mu_i, \sigma_i\),这些随机变量由七对独立同分布的随机变量组成。
在每一对内,参数 \(\mu_i, \sigma_i\) 是相同的
如 Greenfield and Sargent [1993] 第27页表10所述,七个唯一概率 \(P(A_i)\) 的对数正态分布参数已被校准为以下Python代码中的值:
# 组件故障率参数
# (参见 Greenfield & Sargent 1993 表10)
params = [
    (4.28, 1.1947),   # 组件类型 1
    (3.39, 1.1947),   # 组件类型 2
    (2.795, 1.1947),  # 组件类型 3
    (2.717, 1.1947),  # 组件类型 4
    (2.717, 1.1947),  # 组件类型 5
    (1.444, 1.4632),  # 组件类型 6
    (-0.040, 1.4632), # 组件类型 7 (出现8次)
]
备注
由于故障率都很小,这些对数正态分布实际上描述的是 \(P(A_i) \times 10^{-9}\)。
所以我们将在概率质量函数和相关累积分布函数的 \(x\) 轴上标注的概率应该乘以 \(10^{-09}\)
我们定义一个辅助函数来查找数组索引:
def find_nearest(array, value):
    """
    数组中最接近给定值的元素的索引。

    应用于累积分布函数时,这会返回累积概率最接近目标值的网格点,
    对于足够精细离散化的分布而言,这与将分位数定义为满足
    CDF(x) >= q 的最小 x 值是没有区别的。
    """
    array = np.asarray(array)
    idx = (np.abs(array - value)).argmin()
    return idx
我们在以下代码中计算所需的十三个卷积。
(请随意尝试不同的幂参数 \(p\) 值,我们用它来设置网格中的点数,以构建离散化连续对数正态分布的概率质量函数。)
# 设置网格参数
p = 15
I = 2**p
m = 0.05

# 离散化所有组件的故障率分布
# 前6个组件使用各自独特的参数,后8个共享相同的参数
component_pmfs = []
for μ, σ in params[:6]:
    _, pmf, x = discretize_lognormal(μ, σ, I, m)
    component_pmfs.append(pmf)

# 添加8份组件类型7的副本
μ7, σ7 = params[6]
_, pmf7, x = discretize_lognormal(μ7, σ7, I, m)
component_pmfs.extend([pmf7] * 8)

# 通过依次卷积计算系统故障分布
with qe.Timer() as timer:
    system_pmf = component_pmfs[0]
    for pmf in component_pmfs[1:]:
        system_pmf = fftconvolve(system_pmf, pmf)

print(f"13次卷积所需时间: {timer.elapsed:.4f} 秒")

# 卷积结果保持相同的网格间距,但延伸得更远
system_grid = np.arange(len(system_pmf)) * m
print(f"结果中的网格点数: {len(system_pmf):,}")
2.2031 seconds elapsed
13次卷积所需时间: 2.2031 秒
结果中的网格点数: 9,175,027
在绘制累积分布函数之前,我们先来看看密度本身。
fig, ax = plt.subplots(figsize=(10, 6))
upper = 2000
ax.plot(system_grid[:int(upper/m)], system_pmf[:int(upper/m)] / m, 'b-', lw=2)
ax.set_xlabel(r'故障率 (每年 $\times 10^{-9}$)')
ax.set_ylabel('密度')
plt.show()
findfont: Failed to find font weight normal, now using 600.
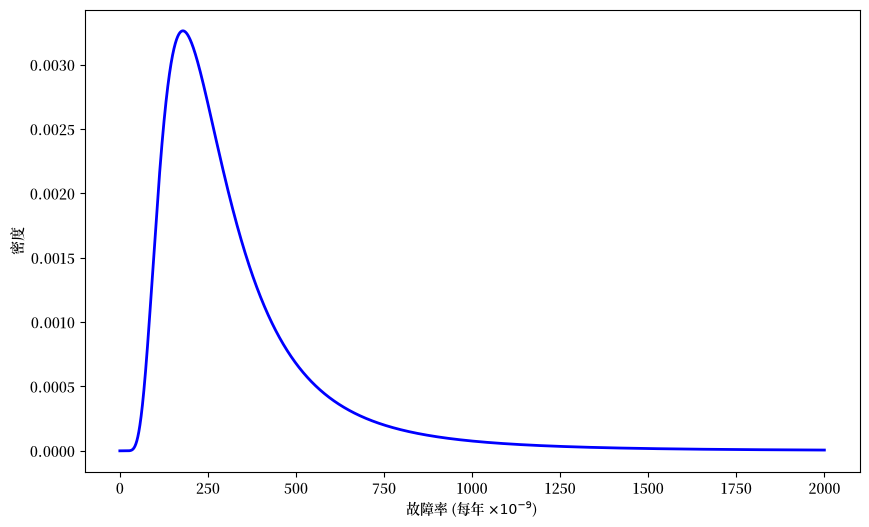
图 14.7 系统故障率的密度#
该密度明显右偏:一条长长的上尾远远延伸至分布主体之外。
正是这种不对称性使得单一的故障率点估计成为一个糟糕的概括,这也是分析者转而报告分位数的原因。
现在我们绘制一个与 Greenfield and Sargent [1993] 第29页图5中的累积分布函数(CDF)相对应的图
# 计算累积分布函数
cdf = np.cumsum(system_pmf)

# 绘制累积分布函数
Nx = 1400
fig, ax = plt.subplots(figsize=(10, 6))
ax.plot(x[:int(Nx / m)], cdf[:int(Nx / m)], 'b-', lw=2)

# 添加关键分位数的参考线
quantile_levels = [0.05, 0.10, 0.50, 0.90, 0.95]
for q in quantile_levels:
    ax.axhline(q, color='gray', linestyle='--', alpha=0.5)

ax.set_xlim(0, Nx)
ax.set_ylim(0, 1)
ax.set_xlabel(r'故障率 (每年 $\times 10^{-9}$)')
ax.set_ylabel('累积概率')
plt.show()
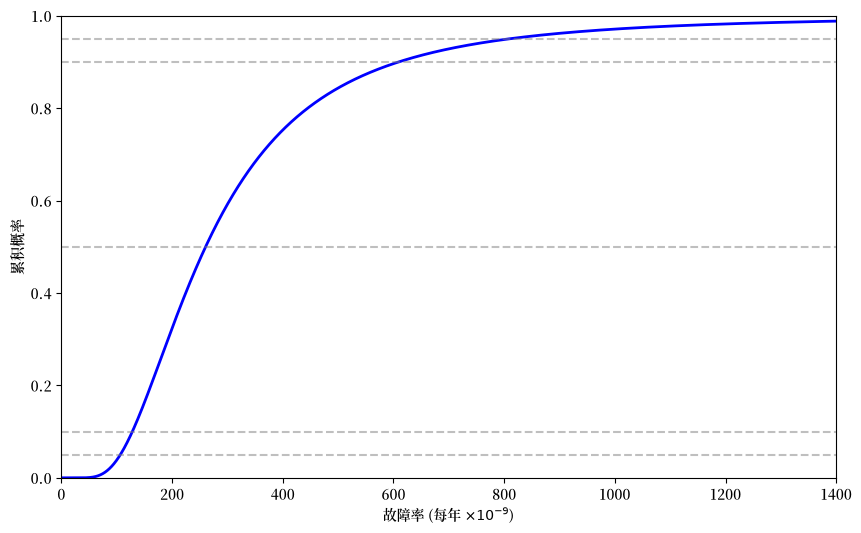
图 14.8 系统故障率的累积分布函数#
我们还展示一个与 Greenfield and Sargent [1993] 第28页表11相对应的表,列出了系统故障率分布的关键分位数
# Greenfield 和 Sargent (1993) 表11中报告的百分位数,
# 及其发表的数值,单位为每年 10^-9
reference = {1.0: 77, 10.0: 130, 50.0: 263, 66.5: 341,
             85.0: 513, 95.0: 811, 99.0: 1480, 99.78: 2490}

table_data = []
for pc, published in reference.items():
    ours = system_grid[find_nearest(cdf, pc/100)]
    table_data.append([f"{pc}%", f"{ours:.1f}", published,
                       f"{100*(ours - published)/published:+.1f}%"])

print("\n系统故障率分位数 (×10^-9 每年):")
print(tabulate(table_data,
      headers=['百分位数', '本文计算值', 'Greenfield-Sargent', '差异'],
      tablefmt='grid'))
系统故障率分位数 (×10^-9 每年):
+------------+--------------+----------------------+--------+
| 百分位数   |   本文计算值 |   Greenfield-Sargent | 差异   |
+============+==============+======================+========+
| 1.0%       |         76.2 |                   77 | -1.1%  |
+------------+--------------+----------------------+--------+
| 10.0%      |        128.2 |                  130 | -1.4%  |
+------------+--------------+----------------------+--------+
| 50.0%      |        260.6 |                  263 | -0.9%  |
+------------+--------------+----------------------+--------+
| 66.5%      |        338.6 |                  341 | -0.7%  |
+------------+--------------+----------------------+--------+
| 85.0%      |        509.4 |                  513 | -0.7%  |
+------------+--------------+----------------------+--------+
| 95.0%      |        807.6 |                  811 | -0.4%  |
+------------+--------------+----------------------+--------+
| 99.0%      |       1470.2 |                 1480 | -0.7%  |
+------------+--------------+----------------------+--------+
| 99.78%     |       2474.9 |                 2490 | -0.6%  |
+------------+--------------+----------------------+--------+
我们计算出的分位数与已发表的数值相差在百分之一点五以内,且都略微偏低。
这些微小的差异反映了所报告参数 \(\mu_i, \sigma_i\) 的精度、网格间距 \(m\) 以及网格截断点的影响。
14.9.2. 解读结果#
这张表中的数字,而非其中任何单一的数值,才是分析的产出。
中位故障率约为每年 \(261 \times 10^{-9}\),而第95百分位数约为 \(808 \times 10^{-9}\),是中位数的三倍。
这种差异并不是在陈述提升机故障的实际频率;它陈述的是分析者对提升机故障频率所知有多么有限。
再来看看分布的均值落在何处。
mean_rate = np.sum(system_grid * system_pmf)
mean_percentile = 100 * cdf[find_nearest(system_grid, mean_rate)]

print(f"平均故障率: {mean_rate:.1f} × 10⁻⁹ 每年")
print(f"均值位于第 {mean_percentile:.1f} 百分位")
平均故障率: 338.1 × 10⁻⁹ 每年
均值位于第 66.4 百分位
由于该分布是偏斜的,均值远高于中位数,大约位于第66百分位处。
这就是为什么 Greenfield and Sargent [1993] 的表11将均值与第66.5百分位数一并记录的原因。
这一实际意义正是最初激发这项研究的动机。
# 美国能源部1990年风险评估中使用的点估计值,以相同单位表示
doe_estimate = 220    # 每年 2.2 × 10^-7

pct = 100 * cdf[find_nearest(system_grid, doe_estimate)]
print(f"美国能源部的点估计值 {doe_estimate} × 10⁻⁹ 位于"
      f"第 {pct:.0f} 百分位")
print(f"因此分析者认为真实故障率超过该值的概率为 {100-pct:.0f}%")
美国能源部的点估计值 220 × 10⁻⁹ 位于第 39 百分位
因此分析者认为真实故障率超过该值的概率为 61%
若一项分析仅报告单一数值来代替整个分布,则无法传达上述任何信息。
Greenfield and Sargent [1993] 正是提出了这一点:根据他们的图,他们将能源部的点估计值定位在第36百分位,并得出结论认为真实故障率高于该值的概率大约为64%。
14.10. 练习#
练习 14.1
我们的离散化涉及两个独立的选择:网格在哪里截断,\(I = 2^p\),以及网格间距有多细,\(m\)。
研究这两者各自控制什么。
固定 \(m = 0.05\),对 \(p = 10, 11, \ldots, 15\) 计算系统故障率的中位数、第95百分位数和第99.78百分位数。对每个 \(p\),还要利用 \(\sum_i \mathbb{P}\{P(A_i) > I\}\) 计算截断所丢弃的概率质量。
固定 \(p = 14\),对 \(m = 0.4, 0.2, 0.1, 0.05, 0.025\) 重复上述计算。
哪个统计量对哪个选择敏感,为什么?讲座中使用的 \(p = 15\),\(m = 0.05\) 选择合理吗?
解答 练习 14.1
from scipy.stats import norm

def system_distribution(p_grid, m_grid):
    "在给定网格上计算整个系统的故障率分布。"
    I_grid = 2**p_grid
    pmfs = []
    for μ_i, σ_i in params[:6]:
        _, pmf_i, _ = discretize_lognormal(μ_i, σ_i, I_grid, m_grid)
        pmfs.append(pmf_i)
    μ7, σ7 = params[6]
    _, pmf7, _ = discretize_lognormal(μ7, σ7, I_grid, m_grid)
    pmfs.extend([pmf7] * 8)

    total = pmfs[0]
    for pmf_i in pmfs[1:]:
        total = fftconvolve(total, pmf_i)
    return total, np.arange(len(total)) * m_grid


def quantiles_of(pmf, grid, levels=(0.5, 0.95, 0.9978)):
    cdf_local = np.cumsum(pmf)
    return [grid[find_nearest(cdf_local, q)] for q in levels]


def discarded_mass(I_grid):
    "组件故障率超出网格终点的概率。"
    lost = sum(norm.sf((np.log(I_grid) - μ_i)/σ_i) for μ_i, σ_i in params[:6])
    μ7, σ7 = params[6]
    return lost + 8 * norm.sf((np.log(I_grid) - μ7)/σ7)


rows = []
for p_test in range(10, 16):
    pmf_t, grid_t = system_distribution(p_test, 0.05)
    med, q95, q9978 = quantiles_of(pmf_t, grid_t)
    rows.append([p_test, 2**p_test, f"{discarded_mass(2**p_test):.1e}",
                 f"{med:.2f}", f"{q95:.2f}", f"{q9978:.2f}"])

print(tabulate(rows, headers=['p', 'I', '丢弃的概率质量',
                              '中位数', '95th', '99.78th'], tablefmt='grid'))
+-----+-------+------------------+----------+--------+-----------+
|   p |     I |   丢弃的概率质量 |   中位数 |   95th |   99.78th |
+=====+=======+==================+==========+========+===========+
|  10 |  1024 |          0.016   |   257.55 | 728.8  |   1247.95 |
+-----+-------+------------------+----------+--------+-----------+
|  11 |  2048 |          0.0028  |   260    | 791.1  |   1870.75 |
+-----+-------+------------------+----------+--------+-----------+
|  12 |  4096 |          0.00039 |   260.5  | 805.3  |   2344.85 |
+-----+-------+------------------+----------+--------+-----------+
|  13 |  8192 |          3.9e-05 |   260.55 | 807.35 |   2460.5  |
+-----+-------+------------------+----------+--------+-----------+
|  14 | 16384 |          2.9e-06 |   260.55 | 807.6  |   2473.85 |
+-----+-------+------------------+----------+--------+-----------+
|  15 | 32768 |          1.6e-07 |   260.55 | 807.6  |   2474.85 |
+-----+-------+------------------+----------+--------+-----------+
rows = []
for m_test in (0.4, 0.2, 0.1, 0.05, 0.025):
    pmf_t, grid_t = system_distribution(14, m_test)
    med, q95, q9978 = quantiles_of(pmf_t, grid_t)
    rows.append([m_test, len(grid_t), f"{med:.3f}", f"{q95:.2f}", f"{q9978:.2f}"])

print(tabulate(rows, headers=['m', '网格点数', '中位数', '95th', '99.78th'],
               tablefmt='grid'))
+-------+------------+----------+--------+-----------+
|     m |   网格点数 |   中位数 |   95th |   99.78th |
+=======+============+==========+========+===========+
| 0.4   |     573427 |  264.4   |  811.6 |   2477.6  |
+-------+------------+----------+--------+-----------+
| 0.2   |    1146867 |  261.8   |  809   |   2475.2  |
+-------+------------+----------+--------+-----------+
| 0.1   |    2293747 |  260.9   |  807.9 |   2474.2  |
+-------+------------+----------+--------+-----------+
| 0.05  |    4587507 |  260.55  |  807.6 |   2473.85 |
+-------+------------+----------+--------+-----------+
| 0.025 |    9175027 |  260.475 |  807.5 |   2473.75 |
+-------+------------+----------+--------+-----------+
这两种选择所起的作用截然不同。
截断决定了 远端尾部。
在 \(p = 10\) 时,第99.78百分位数被严重低估,并且会一直上升,直到大约 \(p = 14\) 附近,此时丢弃的概率质量已降至约 \(10^{-6}\)。
相比之下,中位数在 \(p = 12\) 时就已经稳定:舍弃每个组件极端右尾几乎不会移动它们之和的分布中间部分。
分辨率决定了 整体精度。
将 \(m\) 减半会使每个分位数发生轻微且均匀的移动,且移动幅度很小:从 \(m = 0.4\) 变到 \(m = 0.025\),中位数大约移动1.5%。
讲座中的选择是合理的。
当 \(p = 15\) 时,丢弃的概率质量约为 \(10^{-7}\),因此即使是第99.78百分位数也是准确的,而 \(m = 0.05\) 已经足够精细,进一步细化几乎不会有什么改变。
这告诉我们一个道理:一个对中位数来说看似足够的网格,对上尾部而言可能严重不足,而上尾部恰恰是安全监管者最关心的区域。
练习 14.2
稀有事件近似用 \(P(A) + P(B)\) 替代 \(P(A \cup B)\),从而舍弃了 \(P(A \cap B)\)。
评估该近似在这里的效果如何。
以十四个组件各自的 平均 故障率作为代表值,比较 \(\sum_i p_i\) 与至少一个组件故障的精确概率 \(1 - \prod_i (1 - p_i)\)。
将所有故障率分别乘以 \(10^3\)、\(10^6\) 和 \(10^7\) 后重复上述计算,并报告每种情况下的相对误差。
在什么数量级上,该近似开始变得不可忽视?
解答 练习 14.2
# 十四个组件各自的代表性故障率
component_means = [np.exp(μ_i + 0.5*σ_i**2) for μ_i, σ_i in params[:6]]
μ7, σ7 = params[6]
component_means.extend([np.exp(μ7 + 0.5*σ7**2)] * 8)
component_means = np.array(component_means)

rows = []
for factor, label in ((1e-9, '按校准值'), (1e-6, '× 10³'),
                      (1e-3, '× 10⁶'), (1e-2, '× 10⁷')):
    probs = component_means * factor
    approx = probs.sum()
    exact = 1 - np.prod(1 - probs)
    rows.append([label, f"{approx:.6e}", f"{exact:.6e}",
                 f"{100*(approx - exact)/exact:.4f}%"])

print(tabulate(rows, headers=['故障率', 'Σ pᵢ', '1 - Π(1-pᵢ)',
                              '相对误差'], tablefmt='grid'))
+----------+-------------+---------------+------------+
| 故障率   |        Σ pᵢ |   1 - Π(1-pᵢ) | 相对误差   |
+==========+=============+===============+============+
| 按校准值 | 3.38012e-07 |   3.38012e-07 | 0.0000%    |
+----------+-------------+---------------+------------+
| × 10³    | 0.000338012 |   0.000337969 | 0.0127%    |
+----------+-------------+---------------+------------+
| × 10⁶    | 0.338012    |   0.297883    | 13.4715%   |
+----------+-------------+---------------+------------+
| × 10⁷    | 3.38012     |   1.04157     | 224.5216%  |
+----------+-------------+---------------+------------+
在校准的数量级下,总计每年约 \(3 \times 10^{-7}\),该近似在所示精度下是精确的:被忽略的项数量级为 \(p_i p_j \approx 10^{-14}\)。
将所有故障率乘以一千后,误差仍只有大约万分之一。
只有当各组件的故障概率达到百分之一的量级时,该近似才开始产生实质影响,此时它会使系统故障概率被高估超过百分之十;而当 \(\sum_i p_i\) 接近或超过1时,该近似会彻底失效,甚至可能给出大于1的”概率”。
需要注意的是,一种朴素的检验方式——比较所计算得到的 \(\sum_i P(A_i)\) 分布的均值与各组件均值之和——是无法揭示任何问题的,因为根据期望值的线性性质,无论该近似质量如何,这两个量总是相等的。
练习 14.3
一位得知故障率第95百分位数过高的监管者会想知道应该改进哪些组件。
请通过计算在完全移除每种组件类型后系统故障率的第95百分位数,来回答这个问题(共七种组件类型)。
按对上尾部的贡献程度对各组件类型进行排序,并将该排序与各组件的平均故障率进行比较。
解答 练习 14.3
def system_without(drop):
    "移除组件类型 `drop` 后的系统故障率分布。"
    pmfs = []
    for k, (μ_i, σ_i) in enumerate(params[:6]):
        if k == drop:
            continue
        _, pmf_i, _ = discretize_lognormal(μ_i, σ_i, I, m)
        pmfs.append(pmf_i)
    if drop != 6:
        μ7, σ7 = params[6]
        _, pmf7, _ = discretize_lognormal(μ7, σ7, I, m)
        pmfs.extend([pmf7] * 8)

    total = pmfs[0]
    for pmf_i in pmfs[1:]:
        total = fftconvolve(total, pmf_i)
    return total, np.arange(len(total)) * m


base_q95 = system_grid[find_nearest(cdf, 0.95)]

rows = []
for k in range(7):
    pmf_k, grid_k = system_without(k)
    q95 = grid_k[find_nearest(np.cumsum(pmf_k), 0.95)]
    μ_k, σ_k = params[k]
    n_units = 8 if k == 6 else 1
    rows.append([f"类型 {k+1}", n_units, f"{np.exp(μ_k + 0.5*σ_k**2):.1f}",
                 f"{q95:.1f}", f"{100*(base_q95 - q95)/base_q95:.1f}%"])

rows.sort(key=lambda r: -float(r[4].rstrip('%')))
print(f"包含所有组件时的第95百分位数: {base_q95:.1f}\n")
print(tabulate(rows, headers=['移除对象', '数量', '各自平均故障率',
                              '移除后的第95百分位数', '降幅'],
               tablefmt='grid'))
包含所有组件时的第95百分位数: 807.6

+------------+--------+------------------+------------------------+--------+
| 移除对象   |   数量 |   各自平均故障率 |   移除后的第95百分位数 | 降幅   |
+============+========+==================+========================+========+
| 类型 1     |      1 |            147.5 |                  439.3 | 45.6%  |
+------------+--------+------------------+------------------------+--------+
| 类型 2     |      1 |             60.6 |                  699.4 | 13.4%  |
+------------+--------+------------------+------------------------+--------+
| 类型 3     |      1 |             33.4 |                  760.1 | 5.9%   |
+------------+--------+------------------+------------------------+--------+
| 类型 4     |      1 |             30.9 |                  764.7 | 5.3%   |
+------------+--------+------------------+------------------------+--------+
| 类型 5     |      1 |             30.9 |                  764.7 | 5.3%   |
+------------+--------+------------------+------------------------+--------+
| 类型 7     |      8 |              2.8 |                  783.7 | 3.0%   |
+------------+--------+------------------+------------------------+--------+
| 类型 6     |      1 |             12.4 |                  791.1 | 2.0%   |
+------------+--------+------------------+------------------------+--------+
组件类型1占主导地位:移除这一个单元就能将第95百分位数降低近一半,远超设计者可采取的任何其他改动。
在此案例中,排序与各组件的平均故障率高度一致,因为七种类型的离散程度相近。
但这一点并非普遍成立:均值适中但 \(\sigma\) 较大的组件会对上尾部产生不成比例的贡献,这正是分析者要研究整个分布而非仅仅关注均值的原因。
还需注意,出现8次的类型7的重要性反而不及只出现一次的类型1。
单纯计数组件数量并不能指示风险所在。
练习 14.4
除了通过卷积计算,我们也可以通过模拟来计算系统故障率的分布。
对全部十四个组件的故障率进行抽样、求和,并将得到的分位数与卷积方法的结果进行比较,样本量分别取 \(10^4\)、\(10^5\) 和 \(10^6\)。
比较中位数、第95百分位数和第99.78百分位数。
你会更倾向于使用哪种方法,为什么?
解答 练习 14.4
all_params = list(params[:6]) + [params[6]] * 8
rng_mc = np.random.default_rng(0)
levels = (50, 95, 99.78)

rows = []
for N in (10_000, 100_000, 1_000_000):
    draws = sum(rng_mc.lognormal(μ_i, σ_i, N) for μ_i, σ_i in all_params)
    rows.append([f"{N:,}"] + [f"{np.percentile(draws, pc):.1f}" for pc in levels])

rows.append(['卷积法'] +
            [f"{system_grid[find_nearest(cdf, pc/100)]:.1f}" for pc in levels])

print(tabulate(rows, headers=['方法', '中位数', '95th', '99.78th'],
               tablefmt='grid'))
+-----------+----------+--------+-----------+
| 方法      |   中位数 |   95th |   99.78th |
+===========+==========+========+===========+
| 10,000    |    262.7 |  811.8 |    2240.6 |
+-----------+----------+--------+-----------+
| 100,000   |    261.1 |  807.1 |    2458.4 |
+-----------+----------+--------+-----------+
| 1,000,000 |    260.4 |  807.5 |    2447   |
+-----------+----------+--------+-----------+
| 卷积法    |    260.6 |  807.6 |    2474.9 |
+-----------+----------+--------+-----------+
模拟结果收敛到相同的答案,这为两种计算方法都提供了有用的检验。
这两种方法的误差所在位置不同。
蒙特卡洛误差恰恰在最关键的地方最大:第99.78百分位数大约由五百次抽样中的一次决定,因此在 \(10^4\) 次抽样中只有约二十个观测值用于估计该值,估计结果明显偏离。
相比之下,卷积法一次性计算出整个分布,其误差来自网格本身而非抽样噪声,因此在尾部与中间部分同样精确。
它也是确定性的:换一个随机种子重新运行,答案不会改变。
练习 14.5
整个计算假设十四个组件的故障率在统计上是相互独立的。
研究当它们不独立时会发生什么。
假设
其中 \(z_0\) 是所有组件共同承受的冲击,\(z_1, \ldots, z_{14}\) 是各自独立的特质冲击,均服从标准正态分布。
每个组件仍然保持其原有的边缘分布,但任意两个组件在对数尺度上现在具有相关系数 \(\rho\)。
对 \(\rho = 0, 0.2, 0.5, 0.8\) 模拟系统故障率,并报告中位数、第95、第99和第99.9百分位数。
解释发生了什么,以及这对安全分析意味着什么。
解答 练习 14.5
μ_vec = np.array([q[0] for q in all_params])
σ_vec = np.array([q[1] for q in all_params])

N_sim = 400_000
rng_cc = np.random.default_rng(1)

rows = []
for ρ in (0.0, 0.2, 0.5, 0.8):
    z0 = rng_cc.normal(size=(N_sim, 1))
    zi = rng_cc.normal(size=(N_sim, len(all_params)))
    logs = μ_vec + σ_vec * (np.sqrt(ρ)*z0 + np.sqrt(1-ρ)*zi)
    totals = np.exp(logs).sum(axis=1)
    rows.append([ρ] + [f"{np.percentile(totals, pc):.0f}"
                       for pc in (50, 95, 99, 99.9)])

print(tabulate(rows, headers=['ρ', '中位数', '95th', '99th', '99.9th'],
               tablefmt='grid'))
+-----+----------+--------+--------+----------+
|   ρ |   中位数 |   95th |   99th |   99.9th |
+=====+==========+========+========+==========+
| 0   |      261 |    811 |   1481 |     3235 |
+-----+----------+--------+--------+----------+
| 0.2 |      242 |    910 |   1650 |     3416 |
+-----+----------+--------+--------+----------+
| 0.5 |      209 |   1043 |   2074 |     4396 |
+-----+----------+--------+--------+----------+
| 0.8 |      179 |   1136 |   2444 |     5763 |
+-----+----------+--------+--------+----------+
相关性并不改变每个组件各自的边缘分布,也不改变总和的均值。
它改变的是总和分布的形状。
在组件相互独立的情况下,某个组件出现高值通常会被其他组件的普通取值所抵消,十四个组件的平均效应会产生一个相对集中的总量分布。
而共同冲击消除了这种分散化效应:当 \(z_0\) 较大时,所有组件会同时变差。
结果是总和的分布中位数 更低,而上尾部则 大幅加重。
在 \(\rho = 0.8\) 时,中位数下降约三分之一,而第99.9百分位数则上升约四分之三。
对于安全分析而言,这正是危险的误差方向。
如果在存在共同致因的情况下仍假设各组件相互独立,就会使系统看起来既比实际更安全(通常情况下),又比实际更不容易遭遇极端糟糕的年份。
这正是可靠性研究之所以如此重视识别共用电源、共用维护流程、共同设计缺陷等破坏独立性假设的机制的原因。